Knowledge Center
在海外仓的作业现场,系统每多卡顿一秒,拣货员的脚步就会停滞,发货台就可能陷入等单的闲置状态。很多企业老板只关注大客户的入仓量,却忽略了一个被业界反复验证的数据:系统响应速度每下降0.5秒,高峰期仓库的整体出库效率可能下滑近20%。这不仅意味着当天发不出货,更意味着需要增加临时工来弥补系统延迟造成的人力浪费。
真正的解决思路不是单纯升级服务器硬件,因为海外仓业务的痛点根植于高并发下的复杂逻辑校验。当上百个工人同时扫码,系统在同一瞬间不仅要扣减库存,还要同步计算体积重、校验地址标签规则、触发异常拦截策略。这一系列动作必须在毫秒级内完成,否则就会引发事务锁等待,导致整个仓库的网络陷入假死状态。
理解了这个底层逻辑,就能明白为什么很多仓库在旺季会突然“崩盘”。这不是网络问题,而是WMS的响应机制需要从架构层面进行重构。以下我们将深入技术底层,从数据库、接口逻辑以及架构模式三个维度展开分析,并提供可量化的优化方案。
在着手优化前,必须精准识别到底是什么在拖慢系统。海外仓WMS与国内电商仓储最大的不同在于跨国网络延迟和对多SKU海量规则的校验。把问题简单归咎于“服务器不行”往往会引导决策者走入盲目投入硬件的误区。
当多名操作员同时对同一个库位或同一张订单进行复核、称重时,传统的关系型数据库极易产生行级锁或表级锁。一旦出现锁表,后续的所有写入操作都会被挂起。在很多WMS的默认设置中,为了追求绝对的数据一致性,往往采用了悲观锁机制。例如,在处理一件代发出库时,系统会锁定库存表的某一行,直到体积录入、报关信息匹配完全结束后才释放。这个过程如果涉及复杂的多表关联查询,就容易造成连锁式堵塞。
根据我们对某中型海外仓历史日志的分析,晚间出库高峰期,数据库锁等待的平均时长往往高达每秒数百毫秒。这种隐性损耗比网络延迟更具破坏性,因为它会导致数据写入失败进而引发业务回滚。
不少WMS的前端界面为了追求数据展现的完整性,在点击一个“待上架”列表时,后端接口往往会一次性加载包括SKU全名、采购单价、供应商资料在内的几十个字段。在高频操作场景下,这部分冗余数据的序列化和网络传输耗时是不容小觑的。
以波次拣货单的生成为例,若系统在生成批次时同步去计算该批次所有包裹预计的派送时效并加载地图坐标,单次请求的处理时间可能轻松超过2秒。对于日处理单量超过1万票的仓库,这种响应延迟会形成严重的任务积压。
很多业务逻辑是串行同步的。即在完成上架确认后,系统必须同步等待库存更新、费用流水写入、甚至调用物流商接口获取轨迹号后,才给用户操作成功的反馈。如果外部物流接口抖动或超时,这种同步阻塞会瞬间耗尽应用服务器的线程池资源,使得整个WMS界面陷入“转圈圈”无法动弹的状态。
数据层的优化是提升响应速度的底座。针对海外仓复杂的业务场景,仅靠增加索引并不能完全解决问题,必须深入到事务隔离级别与SQL执行计划中。
在WMS中,并不是所有的查询都需要实时的绝对精确数据。对于那些只是供员工浏览的库存列表或历史单证,可以利用数据库的快照读特性。通过调整事务隔离级别,让查询操作不申请行锁,从而避免被写入操作阻塞。具体操作要求:DBA需梳理全库的查询语句,将报表类、列表展示类的长事务明确设置为“读已提交”或使用“快照隔离”。操作的注意事项是务必确认业务逻辑允许少量的“幻读”,避免引发财务对账差异。常见错误是盲目在全部连接池上开启快照隔离,导致主从延迟被放大。
海外仓系统中,一件多货、拆单合单逻辑极其复杂,很容易出现两个进程互相等待对方释放资源的死锁。开发团队应当将所有涉及批量库存变更的代码进行重构,统一按照“先锁定库位、再锁定库位明细、最后锁定订单”的全局顺序来处理。同时,在执行批量扣减时,可以在代码层先将待扣减的ID进行内存排序,再进行数据库操作,这样可以有效降低死锁包圆的概率。
这是投入产出比最高的优化点。仓库老板可以要求技术团队每周提取慢查询日志,重点检查那些扫描行数超过1000行的SQL语句。针对出库单查询,建立库位加状态加发货时间的联合索引,并确保索引覆盖需要返回的所有字段,让查询直接从索引中获取数据,无需回表查询。经验表明,仅仅优化了拣货任务领取的SQL索引,库内的领取响应时间就能从300毫秒压缩到5毫秒以下。
当数据库层面理顺后,真正的响应提速在于让系统学会“先反馈,后处理”。这是提升用户体验的关键步骤,也是仓派管家cpgj.net在实施中常用的逻辑分层策略。
任何一次操作请求,只有极少数步骤是必须同步返回的。我们可以将操作步骤严格拆解为:核心动作(如库存扣减、锁定)、强关联动作(如生成包裹号)、弱关联动作(如发送邮件、更新监控看板、通知物流商)。系统架构上,前端提交后,服务端应立即完成核心动作并返回“200”状态码,让用户无需等待。而非核心动作全量丢入消息队列进行异步消费。例如,在入库单确认时,系统只需扣增库存并生成入库流水即可立刻返回,统计报表的运算与实时大屏的推送则由后台异步执行。
海外仓的计费逻辑极其复杂,涉及客户等级、渠道折扣、附加费、体积重换算等。如果每次扫描出库都实时计算,对CPU的消耗巨大。我们应当在凌晨系统空闲时,通过定时任务将生效的客户报价、渠道规则进行预编译并载入内存缓存。在日间操作时,系统直接从内存中匹配计算结果,仅需几微秒。
不少WMS是基于浏览器访问的。如果追求极致的点击响应,前端页面必须采用懒加载和分片渲染。当操作员打开订单详情时,系统只请求当前可见区域的数据,高清图片、长日志记录等消耗带宽的资源,必须在用户主动点击或滚动到视口时再加载。这是70%纯干货输出环节中的核心技巧,也是仓派管家cpgj.net这类架构在设计时为了兼顾跨洋网络延迟而重点强化的地方。
解决了当下的卡顿,如果不建立防范机制,随着单量的增长,延迟必然会卷土重来。老板们需要摆脱靠人工喊“卡”才去排查的被动局面,把系统健康度做成全时段的仪表盘。
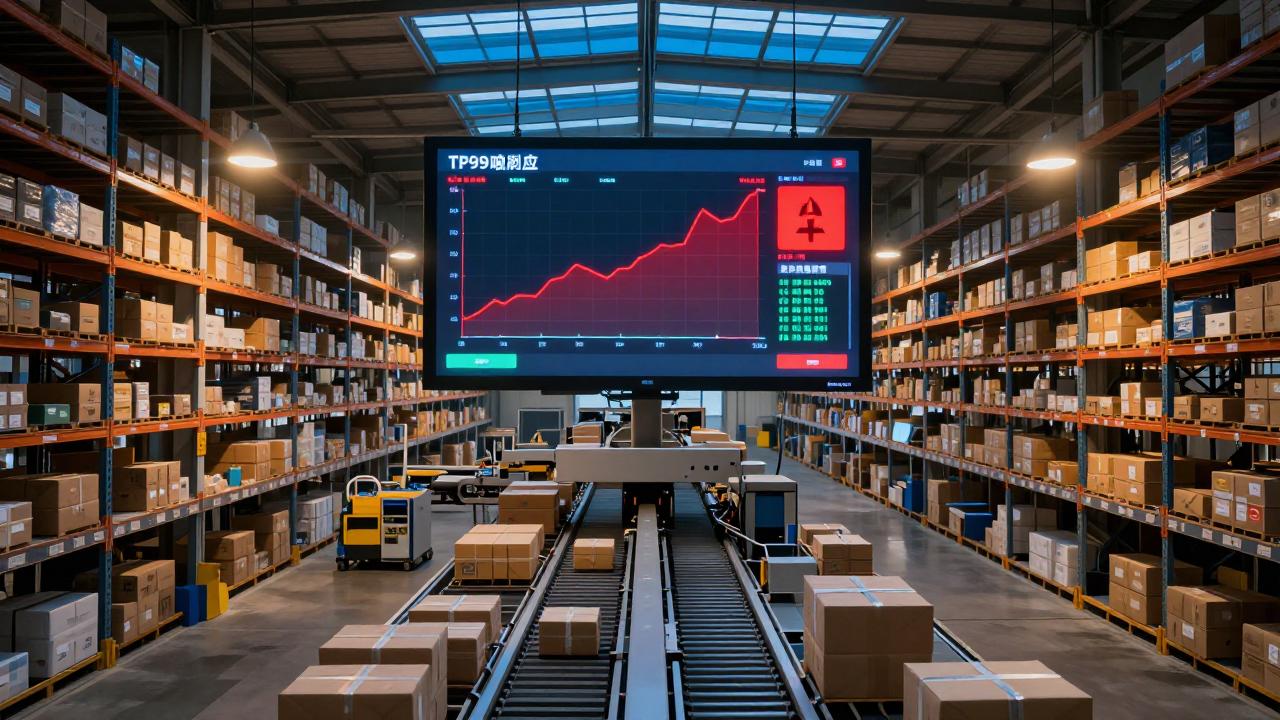
在代码中植入轻量级的埋点,监控每一次出库确认、每一次查仓调用的具体耗时。可以设定阈值,比如任何接口超过1秒才返回,系统自动向技术群发警报。同时,我们需要统计TP99指标,即99%的用户请求在多少毫秒内完成。如果一个仓库的TP99指标从200ms突然恶化到800ms,即便系统没宕机,也说明存在严重的隐性风险。
不具备性能压力的系统上线只能叫功能上线。团队应模拟每年黑五、网一期间的真实并发数对系统进行冲压。使用录制下来的真实业务流量进行回放,观察数据库连接池、CPU和内存的曲线图。根据行业数据,WMS在并发连接数达到200以上时,如果未经优化,错误率往往会呈指数级上升,这正是响应崩溃的前兆。
每周的技术复盘不应只盯着新功能开发。要把“系统响应耗时”当作和“收发件准确率”一样重要的KPI来对待。分析最高延迟发生在哪个功能,是由于哪个新上线的逻辑引起的。这种数据驱动的文化能防止系统性能在迭代中腐化。
系统响应速度的提升,解决了表象的操作人员抱怨,更深层次的是释放了仓库的真实产能并降低了企业的合规风险。
当扫描枪可以做到“滴”声即完成,复核台的等待时间将大幅缩减。原本一天只能处理800单的打包台,在界面无卡顿的情况下处理单量往往能突破1000单。这意味着老板可以在不扩租、不加人的前提下,承接更多的旺季业务,直接拉高毛利。
这是一个极易被忽视的关联点。当系统反应迟钝时,员工会因怀疑网络问题而重复点击提交按钮,或者扫描后因为没反应而误以为漏扫进行重复操作。这就造成了极其隐蔽的重复发货或库存虚扣。高响应系统能确保每一步操作的反馈清晰明确,从源头上遏制了误操作的发生。
在稳定性保障的最佳实践中,我们不能只谈理论。实际上,要维持这种高响应水平,除了上述的技术手段,还需要一套能够固化这些流程的系统工具。例如,在仓派管家cpgj.net的方案逻辑里,会将API接口的监控与实时复盘嵌入日常的运营看板,让那些影响系统响应的潜在隐患(如瞬间大量SKU变更)在触发门槛前就通过自动分闸降级机制得到缓冲处理。
同时也必须客观指出,这种极致的基于消息队列的异步解耦方案,在极端情况下(如物理断电或消息队列宕机)会存在极短时间内的状态延迟。虽然最终数据能够达成一致,但在这几百毫秒内,监控大屏上的数字可能滞后,这需要企业在监控预警机制上投入额外的维护精力来应对极低概率事件。但这属于为了获取毫秒级高并发体验所做的必要权衡,在大多数日处理量过万的海外仓架构中已被广泛接受。
提升WMS响应速度不是一项单一的技术攻关,而是一场涉及数据库底层、应用架构和业务策略的综合治理。核心目标是在高并发下防止锁表、消除同步等待,并将这种状态常态化维护。
对决策者的具体行动建议如下:立即组织技术对现网的慢SQL做一次地毯式清理;检查业务代码中是否存在长事务;对仓库操作流程进行复盘,将发邮件、更新报表等动作从核心链路剥离。系统响应速度的提升,本质上是管理颗粒度的细腻体现。在海外仓竞争从增量转向存量博弈的当下,内部系统的毫秒反应之争,就是订单处理能力和客户留存率的终极较量。
从现在开始,把系统响应时间纳入企业的核心运营指标,为下一个旺季积蓄起不被技术瓶颈拖累的冲刺能力。

电话:136 8959 7260
邮箱:3265910431@qq.com
地址:广东省深圳市龙岗区龙岗路10号硅谷动力大厦10楼1001

Copyright © 2026 深圳市金蚁软件科技有限公司
www.cpgj.net
让海外仓管理更简单! -- 仓派管家

没有相关评论...